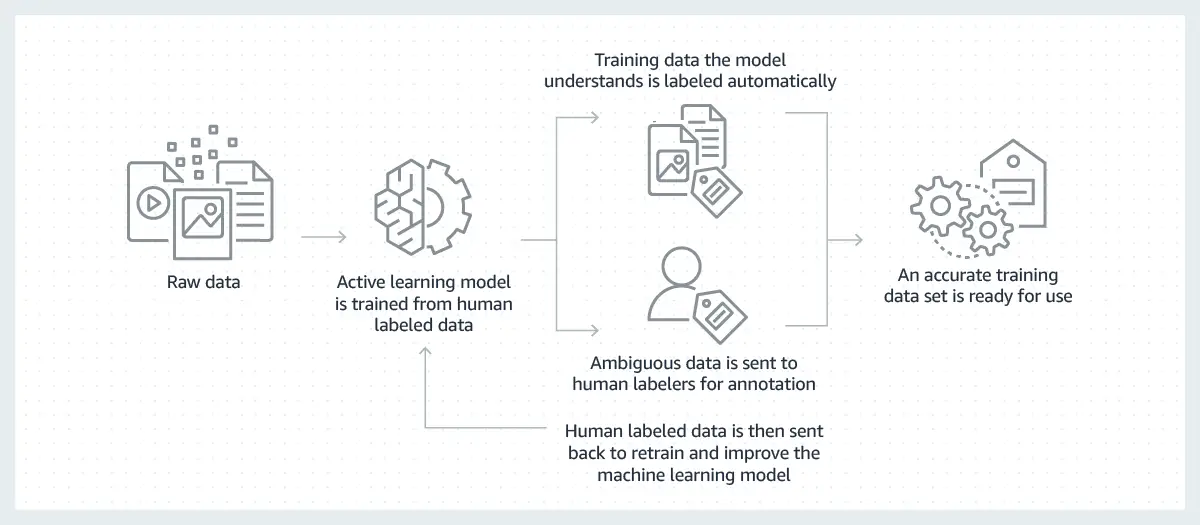
A rotulagem de dados é uma etapa fundamental no desenvolvimento de inteligência artificial. Ela consiste em identificar e marcar diferentes objetos nos dados brutos para melhorar a precisão dos modelos de aprendizado de máquina. A rotulagem de dados ajuda a adicionar contexto relevante aos dados e a garantir previsões mais precisas. Existem diferentes tipos de rotulagem de dados, como a automatizada, em que não há envolvimento humano na etiquetagem, a manual, que envolve a rotulagem feita por humanos, e a semissupervisionada, que combina técnicas automatizadas e manuais. A rotulagem de dados é crucial para garantir a precisão e confiabilidade dos modelos de aprendizado de máquina. Ela pode ser usada em várias áreas, como veículos autônomos, processamento de imagens médicas e processamento de linguagem natural. No entanto, a rotulagem de dados também apresenta desafios, como restrições de custo e tempo, garantia de consistência e lidar com dados ambíguos. Para superar esses desafios, é importante seguir as melhores práticas, como estabelecer diretrizes claras, implementar medidas eficientes de controle de qualidade e fornecer treinamento contínuo e feedback aos rotuladores. No futuro, a rotulagem de dados continuará avançando com o desenvolvimento de tecnologias de inteligência artificial. Ela desempenhará um papel importante no aprimoramento dos modelos de aprendizado de máquina e no desenvolvimento de novas tecnologias. No entanto, é importante considerar questões éticas na rotulagem de dados, como mitigar preconceitos, garantir representação justa e promover transparência e responsabilidade. Em resumo, a rotulagem de dados é fundamental para o desenvolvimento da inteligência artificial, proporcionando modelos de aprendizado de máquina mais precisos e confiáveis. É importante seguir as melhores práticas e considerar questões éticas para garantir o uso correto e eficaz dos dados rotulados. Com informaçõesAdicione ao Google Notícias
Descubra o que é rotulagem de dados - um processo crucial na criação da IA!
Ouvindo o artigo
Resumo por IA
Resumo gerado por IA, revisado pela redação.